大模型落地,最怕两种极端:
一种是把它当万能员工,什么活都扔过去;
另一种是只做个聊天框,业务系统一点没接。
真正有用的做法,是从具体场景出发,先判断:这个任务到底需要模型“会什么”。
下面拆几个常见方向。
一、智能客服与内部问答
典型需求:
回答产品规则;
查询订单状态;
解释售后政策;
辅助人工坐席。
技术组合通常是:
知识库检索;
意图识别;
结构化输出;
工具调用;
人工转接。
关键不是让模型背答案,而是让它先查最新资料,再回答。
避坑点:
文档没清洗,检索出来一堆废信息;
没有引用来源,答错也无法追溯;
涉及退款、合同、账户操作时,直接执行不设权限。
稳妥做法是:模型先给建议,关键动作由系统规则和人工确认完成。
二、企业知识库与文档助理
适合制度查询、项目复盘、研报摘要、合同初筛等场景。
比如问:
“上季度华东区投放复盘里,哪些渠道ROI低于阈值?”
这类问题不能靠模型记忆,需要:
文档解析;
表格与正文结构化;
向量检索;
条件过滤;
生成摘要并标注出处。
这里最值钱的能力不是“生成”,而是“读得准”。
很多项目失败,不是模型不行,而是原始文档混乱:扫描件没OCR、表格没还原、版本没区分。
先做数据治理,再做AI,顺序不能反。
三、数据分析与自动研报
场景包括经营分析、行业研究、日志排查、销售归因。
模型可以做:
SQL生成;
图表解释;
异常检测;
报告初稿;
多轮追问。
但要注意:
数据权限必须隔离;
数值不能让模型自由估算;
关键指标要回查数据库;
报告里要区分“模型推断”和“系统数据”。
AI适合做分析助理,不适合单独对最终结论负责。
四、研发与运维辅助
在代码场景里,大模型常用于:
写单元测试;
解释报错;
生成接口文档;
做代码审查;
日志归因。
落地时要接仓库、CI、日志系统,而不是只在聊天框里复制代码。
更进一步的形态是:
模型读PR差异;
自动补测试用例;
标出潜在风险;
生成修复建议;
人工确认后再合并。
这里的核心是“人机协作”,不是全自动替人改代码。
五、内容生产与营销辅助
适合选题、大纲、标题、脚本、摘要、多平台改写。
但要注意版权和事实核查:
引用数据要可验证;
人物事件不能凭模型记忆编造;
医疗、金融、法律类内容要有专业复核;
发布前保留人工审校环节。
AI能把内容生产提速,却不能替代责任边界。
六、一个通用的落地框架
不管做什么行业,都可以用这个顺序:
第一步:选小场景
别一上来做“全公司智能大脑”。
先找一个高频、低风险、能看见收益的点。
第二步:理清数据
哪些文档可用?
哪些数据有权限?
哪些结果必须可追溯?
第三步:设计流程
不是“问一句答一句”,而是:
输入 → 检索 → 工具 → 推理 → 校验 → 输出。
第四步:建立评估
准备一批真实问题,记录准确率、稳定性、耗时和成本。
第五步:逐步扩边界
跑通一个场景后,再复制到客服、运营、研发、分析等环节。
七、未来更像“组装能力”,不是“单点魔法”
大模型应用成熟的标志,不是模型会聊天,而是:
知道自己的知识边界;
能查资料;
能调工具;
能记住上下文;
能说明依据;
出错能恢复;
成本可预测。
对普通从业者来说,不用恐惧“AI替代人”,更该关心三件事:
自己的业务能不能被拆成清晰流程;
自己手里有没有可治理的数据;
自己能不能判断AI结果对不对。
AI落地不是把人拿掉,而是把重复劳动外包给系统,把人的判断留在关键节点。
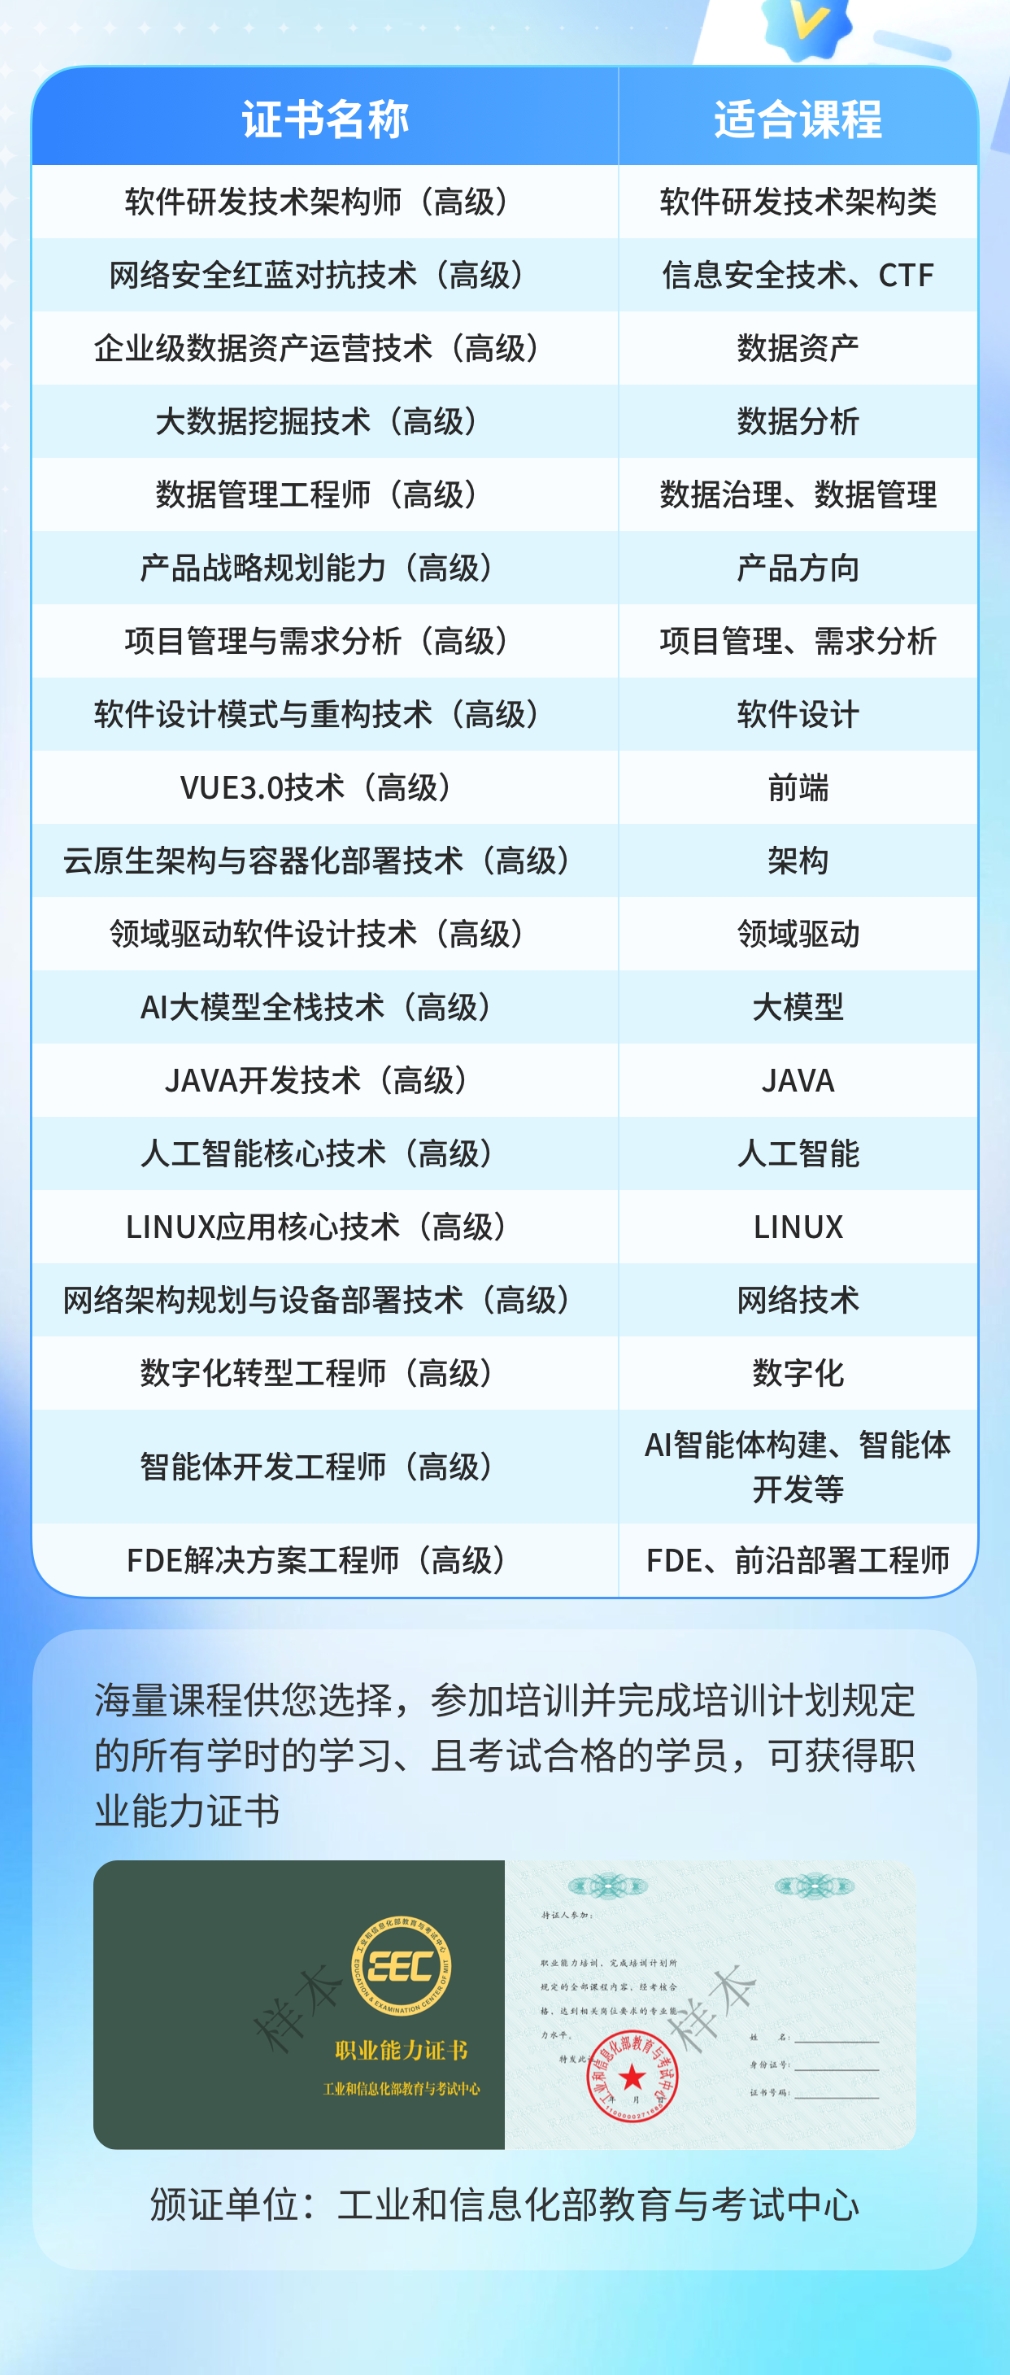
EEC工信教考中心,AI大模型应用工程师,北京青蓝智慧科技
马老师13521730416
丁老师13522094648